
Kunstmatige intelligentie is niet meer weg te denken uit ons dagelijks werk en digitale hobby’s. Toch kleeft er aan populaire cloudgebaseerde diensten vaak een tweeledig nadeel: een terugkerend maandabonnement en het feit dat jouw gevoelige documenten, broncode of persoonlijke notities naar externe servers worden verstuurd.
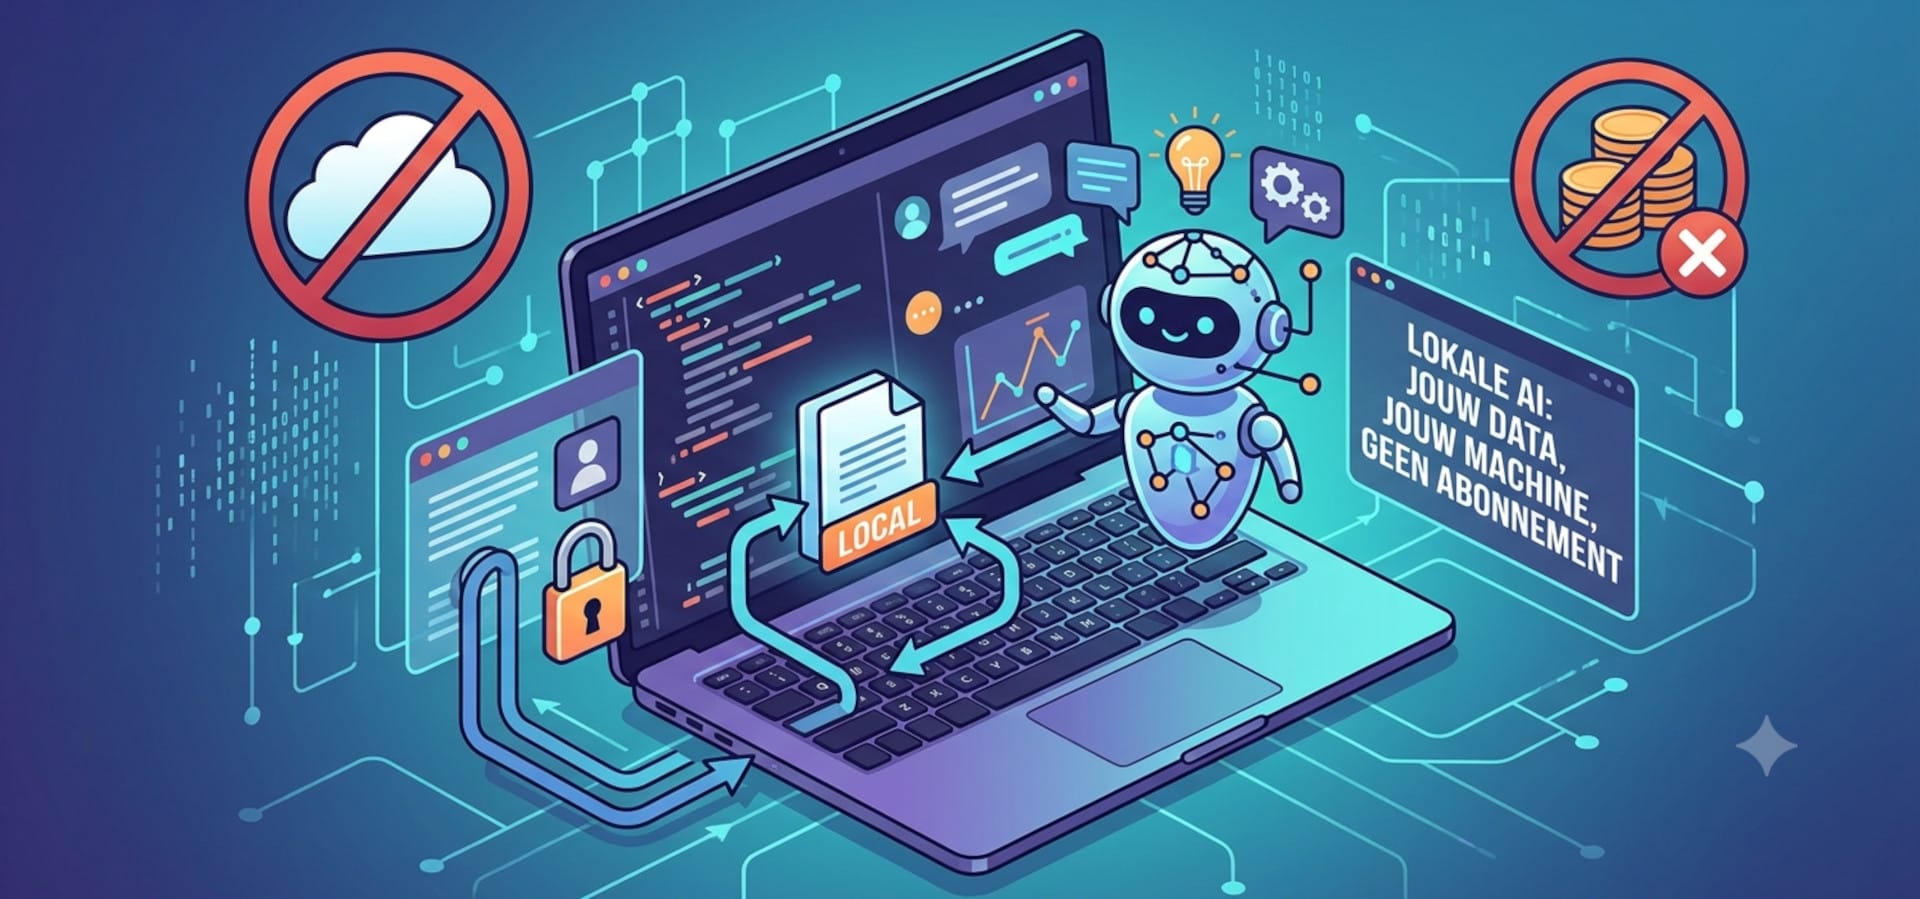
Het goede nieuws? Je kunt krachtige Large Language Models (LLM’s) vandaag de dag volledig lokaal op je eigen computer laten draaien — 100% privé, gratis en offline.
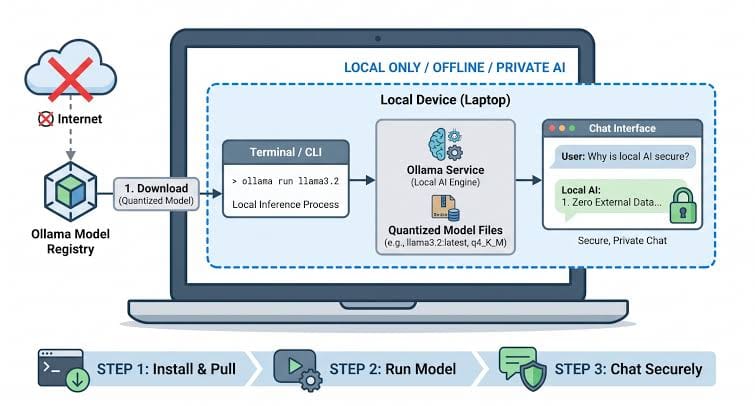
Hoe een lokaal LLM offline werkt op je eigen apparaat. Bron: Machine Learning Mastery
Waarom overstappen op een lokale AI-assistent?
Het draaien van een lokaal AI-model biedt voordelen die geen enkele clouddienst kan evenaren:
- Volledige privacy & datasoevereiniteit: Geen enkele query of bestand verlaat jouw systeem. Ideaal voor het verwerken van vertrouwelijke code, administratie of persoonlijke dagboeken.
- Geen abonnementskosten: Zodra je de hardware hebt, kost het draaien van modellen je niets meer dan een beetje elektriciteit.
- Geen censuur of willekeurige limieten: Je bent niet gebonden aan API-limieten, snelheidsbeperkingen of streng afgestelde inhoudsfilters.
- Werkt offline: Zelfs zonder internetverbinding blijft je assistent direct beschikbaar.
Wat heb je aan hardware nodig?
De tijd dat je een datacenter nodig had om een taalmodel te draaien is voorbij, dankzij technieken zoals quantisatie (het efficiënter opslaan van modelparameters). Toch blijft geheugen de belangrijkste bottleneck.
| Hardwarecomponent | Minimale eis | Aanbevolen voor vlot gebruik |
| Werkgeheugen (RAM) | 16 GB | 32 GB of meer |
| Videokaart (GPU) | Geïntegreerde GPU / CPU-mode | Nvidia GPU met 8-16 GB VRAM of Apple Silicon (M-serie) |
| Opslag | 20 GB vrije SSD-ruimte | NVMe SSD met 50+ GB vrije ruimte |
Pro-tip voor geheugen:
- 7B/8B-modellen (zoals Llama 3 of Mistral) vragen ongeveer 6 tot 8 GB geheugen en draaien uitstekend op de meeste moderne laptops en desktops.
- 14B tot 32B-modellen bieden aanmerkelijk betere logica en codeergewoonten, maar vereisen minimaal 16 tot 24 GB aan VRAM of gedeeld systeemgeheugen.
Eenvoudig aan de slag met Ollama
Het opzetten van een lokaal model was vroeger een ingewikkeld proces met Python-omgevingen en CUDA-drivers. Tegenwoordig is het binnen een paar minuten geregeld met hulpprogramma’s zoals Ollama of LM Studio.
1.Download en installeer Ollama: 1 minuut.
Download de installer voor Linux, macOS of Windows via de officiële website van Ollama.
2.Haal een model op via de terminal: Afhankelijk van je internetsnelheid.
Open je terminal of opdrachtherstel en start direct een open-source model met het commando:
ollama run llama3.2
3.Chat direct in de terminal of koppel een GUI: Direct gereed.
Je kunt nu vragen stellen in de terminal. Wil je liever een vertrouwde ChatGPT-achtige interface? Koppel Ollama eenvoudig aan een grafische schil zoals Open WebUI of Text Generation WebUI.
Populaire open-source modellen om te proberen
- Llama 3.1 / 3.2 (Meta): Uitstekende allrounders voor tekstschrijven, samenvatten en logisch redeneren.
- Qwen 2.5 (Alibaba Cloud): Sterk in meertalige taken (inclusief Nederlands) en programmeren.
- DeepSeek-Coder / Codestral: Speciaal getraind voor het genereren, analyseren en refactoren van broncode.