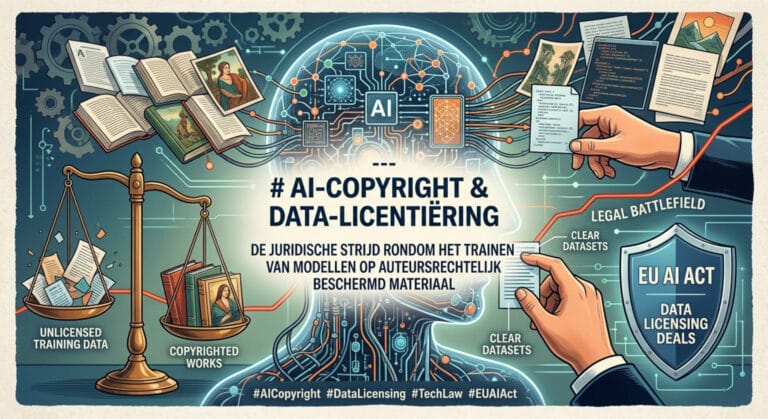
AI-Copyright en data-licentiëring: De juridische strijd rondom het trainen van modellen op auteursrechtelijk beschermd materiaal
De snelle opkomst van generatieve AI heeft de digitale wereld op z'n kop gezet, maar onder de motorkap van deze technologische revolutie woedt een felle juridische strijd. Om geavanceerde taalmodellen en beeldgeneratoren te trainen, schrapen AI-bedrijven terabytes aan data van het internet. Het probleem? Een aanzienlijk deel daarvan bestaat uit auteursrechtelijk beschermd materiaal: artikelen, boeken, kunstwerken, muziek en code.