
Tot voor kort praatten we met kunstmatige intelligentie via een digitale spleet. Je typte een vraag en kreeg tekst terug. Hoewel indrukwekkend, miste er iets essentieels: de fysieke context van onze wereld.
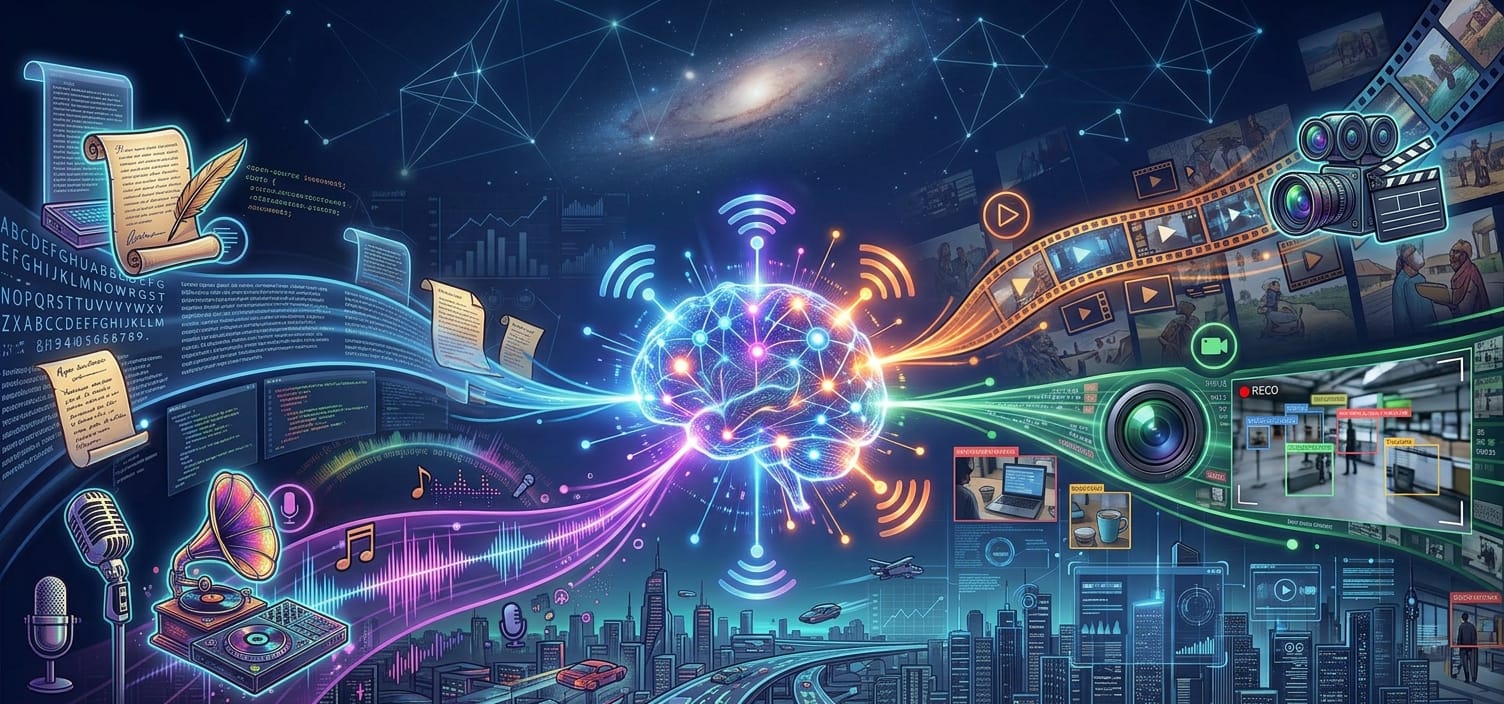
Met de komst van Large Multimodal Models (LMMs) is die barrière definitief verdwenen. Deze AI-systemen verwerken niet langer enkel losse lappen tekst, maar combineren tekst, audio, video en zelfs live camerabeelden in één doorlopende datastroom. Het resultaat? Een AI die de wereld niet meer alleen leest, maar haar in real-time ziet en hoort.
Wat is een Large Multimodal Model (LMM)?
Traditionele Large Language Models (LLMs) zijn getraind op geschreven taal. Een LMM bouwt hierop voort door verschillende ‘modaliteiten’ (inputtypen) te koppelen aan hetzelfde centrale verwerkingsbrein.
In plaats van dat een afzonderlijk vision-model een foto analyseert en het resultaat vertaalt naar tekst voor de AI, verwerkt een native LMM alle data direct via één architectuur. Video-embeddings, audiogolven en visual pixels worden omgezet naar tokens die de AI simultaan kan begrijpen.
┌────────────────────────────────────────────────────────┐
│                   Input Modaliteiten                   │
│      [ Tekst ]   [ Audio ]   [ Video ]   [ Live Cam ]  │
└───────────────────────────┬────────────────────────────┘
                            │
                            ▼
┌────────────────────────────────────────────────────────┐
│            Large Multimodal Model (LMM)                │
│       - Directe fusie van visuele & auditieve data     │
│       - Real-time patroonherkenning & redenering       │
└───────────────────────────┬────────────────────────────┘
                            │
                            ▼
┌────────────────────────────────────────────────────────┐
│                  Multimodale Responsen                 │
│      [ Spraak ]   [ Acties ]   [ Tekst / Code ]        │
└────────────────────────────────────────────────────────┘
Waarom live camerabeelden en audio de gamechanger zijn
De echte doorbraak van moderne LMM’s zit in sub-second latency (verwerking zonder voelbare vertraging). Wanneer je je smartphonecamera op een kapotte fietsketting richt en vraagt “Wat doe ik verkeerd?”, gebeurt het volgende tegelijkertijd:
- Visuele analyse: De AI herkent het specifieke onderdeel en ziet dat de ketting verkeerd om het tandwiel loopt.
- Audio-interpretatie: De AI hoort het geschraap op de achtergrond wanneer je aan de trapper draait.
- Contextuele taal: De AI geeft direct gesproken instructies terug, afgestemd op jouw bewegingen in het beeld.
Dit verandert de AI-ervaring van een zoekmachine in een co-piloot voor de fysieke werkelijkheid.
Praktische toepassingen
| Sector | Hoe LMMs het werk veranderen |
| Gezondheidszorg | Een arts kan live beelden van een echo combineren met gesproken observaties; de AI leest simultaan patiëntdossiers en adviseert in real-time. |
| Klantenservice & support | Monteurs op locatie kijken samen met de AI naar complexe machines. De AI leest fysieke meters af en wijst visueel aan waar het probleem zit. |
| Educatie & begeleiding | Een virtuele tutor kijkt mee terwijl een student een wiskundeopgave op papier uitwerkt en grijpt in zodra de pen een verkeerde stap zet. |
| Robotica & automatisering | Industriële robots gebruiken LMM’s om autonoom te navigeren, obstakels te herkennen en gesproken commando’s direct te vertalen naar fysieke handelingen. |
De uitdagingen van multimodale AI
Hoe indrukwekkend deze modellen ook zijn, er blijven technische en ethische horden:
- Compute & Energieverbruik: Het verwerken van high-definition video in 60 frames per seconde vergt enorm veel rekenkracht in vergelijking met platte tekst.
- Privacy & Live Surveillance: Een AI die continu meekijkt via een camera of meehoort via een microfoon brengt grote privacyvraagstukken met zich mee.
- Hallucinaties in Beeld: Een model kan visuele elementen ‘verzien’ (bijvoorbeeld een foutief afgelezen getal op een meter), wat kritieke risico’s meebrengt in sectoren als de zorg.
Samenvattend
Large Multimodal Models markeren het einde van het “typ-tijdperk” van kunstmatige intelligentie. Door tekst, spraak en live video naadloos te combineren, komen we dicht in de buurt van AI-assistenten die de wereld op dezelfde manier ervaren als wij.