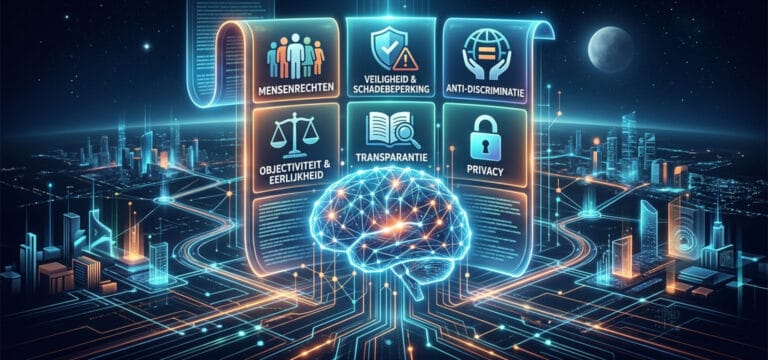
Constitutional AI: Hoe we AI trainen met ethische grondwetten in plaats van menselijke feedback
Artificial Intelligence groeit razendsnel. Om te zorgen dat AI-modellen veilig, behulpzaam en eerlijk blijven, vertrouwden we lange tijd op één specifieke methode: RLHF (Reinforcement Learning from Human Feedback). Hierbij beoordelen menselijke testers de antwoorden van de AI en geven ze cijfers of voorkeuren door.