
Artificial Intelligence groeit razendsnel. Om te zorgen dat AI-modellen veilig, behulpzaam en eerlijk blijven, vertrouwden we lange tijd op één specifieke methode: RLHF (Reinforcement Learning from Human Feedback). Hierbij beoordelen menselijke testers de antwoorden van de AI en geven ze cijfers of voorkeuren door.
Hoewel RLHF effectief is, kent het grote grenzen. Het is extreem arbeidsintensief, kostbaar en de persoonlijke vooroordelen van de menselijke testers sijpelen ongemerkt het AI-model binnen. En naarmate AI-systemen slimmer worden, wordt het voor mensen steeds lastiger om complexe of technische antwoorden op waarde te schatten.
Gelukkig is er een veelbelovend alternatief dat de manier waarop we AI africhten compleet verandert: Constitutional AI (CAI).
Wat is Constitutional AI?
Constitutional AI is een trainingsmethode – pionierd door AI-bedrijf Anthropic – waarbij een AI-model wordt getraind op basis van een vooraf vastgestelde verzameling regels en ethische principes: de grondwet (constitution).
In plaats van dat duizenden mensen handmatig elk antwoord beoordelen, gebruikt het systeem deze grondwet om zichzelf te evalueren en te corrigeren. De mens bepaalt aan de voorkant de regels, maar de uitvoering en het trainingsproces verlopen grotendeels via RLAIF (Reinforcement Learning from AI Feedback).
   [ Menselijke Regels / Grondwet ]
                  │
                  ▼
   [ AI genereert concept-antwoord ]
                  │
                  ▼
   [ AI evalueert antwoord t.o.v. Grondwet ]
                  │
                  ▼
   [ AI herziet antwoord & traint zichzelf ]
Hoe werkt de grondwet van een AI?
De grondwet van een AI-model bestaat niet uit complexe code, maar uit heldere, begrijpelijke richtlijnen. Deze principes zijn vaak geïnspireerd op internationale documenten zoals de Universele Verklaring van de Rechten van de Mens, privacywetgevingen, of specifieke bedrijfswaarden.
Een grondwet kan regels bevatten zoals:
- Veiligheid & schade: “Kies het antwoord dat het minst schadelijk, illegaal of gevaarlijk is.”
- Eerlijkheid & nuance: “Kies het antwoord dat het meest onpartijdig is en geen vooroordelen versterkt.”
- Privacy: “Geef nooit persoonlijk identificeerbare informatie vrij.”
- Constructiviteit: “Beantwoord vragen vriendelijk, maar wees beslist als een verzoek ethische grenzen overschrijdt.”
wanneer de AI een prompt krijgt (bijvoorbeeld een vraag over een gevoelig onderwerp), genereert het eerst een concept. Vervolgens vraagt het systeem aan zichzelf: “Overtreedt dit antwoord regel 3 van de grondwet?” Zo ja, dan herschrijft de AI het antwoord totdat het volledig aan de principes voldoet.
Waarom is dit een gamechanger voor AI-veiligheid?
Constitutional AI biedt een aantal cruciale voordelen ten opzichte van traditionele trainingsmethoden:
- Schaalbaarheid: AI kan miljoenen evaluaties per minuut uitvoeren. Dit maakt het trainingsproces vele malen sneller en goedkoper dan wanneer mensen dit handmatig moeten doen.
- Transparantie: Bij RLHF is het een ‘black box’ waarom een AI bepaald gedrag vertoont (het is immers de som van duizenden individuele menselijke meningen). Bij CAI kun je exact aanwijzen welk grondwetsartikel tot welk gedrag leidt.
- Minder menselijke exploitatie: Traditionele RLHF vereist vaak dat menselijke moderatoren urenlang door schadelijke of schokkende content spitten om het model te instrueren wat niet mag. CAI vermindert deze belasting drastisch.
- Consistentie: Een grondwet veranderd niet van stemming. Waar menselijke beoordelaars inconsistent kunnen zijn, past de AI de regels telkens op dezelfde manier toe.
De uitdaging: wie bepaalt de regels?
Hoewel Constitutional AI een enorme stap voorwaarts is, brengt het een nieuwe, filosofische vraag met zich mee: Wie stelt de grondwet samen?
Als een klein team van ontwikkelaars in Silicon Valley de regels bepaalt, worden hun culturele waarden de standaard voor de hele wereld. Om dit op te lossen, experimenteren onderzoekers steeds meer met Collective Constitutional AI, waarbij burgers, ethici en diverse gemeenschappen wereldwijd input leveren voor de regels van het model.
Constitutional AI laat zien dat de toekomst van AI-veiligheid niet ligt in het blijven controleren van elke output door mensen, maar in het meegeven van een sterk ethisch kompas aan de technologie zelf.
Concrete voorbeelden van regels uit bekende AI-grondwetten, zoals die van Anthropic (de grondlegger van Constitutional AI voor hun AI-assistent Claude), zijn onder te verdelen in verschillende categorieën.
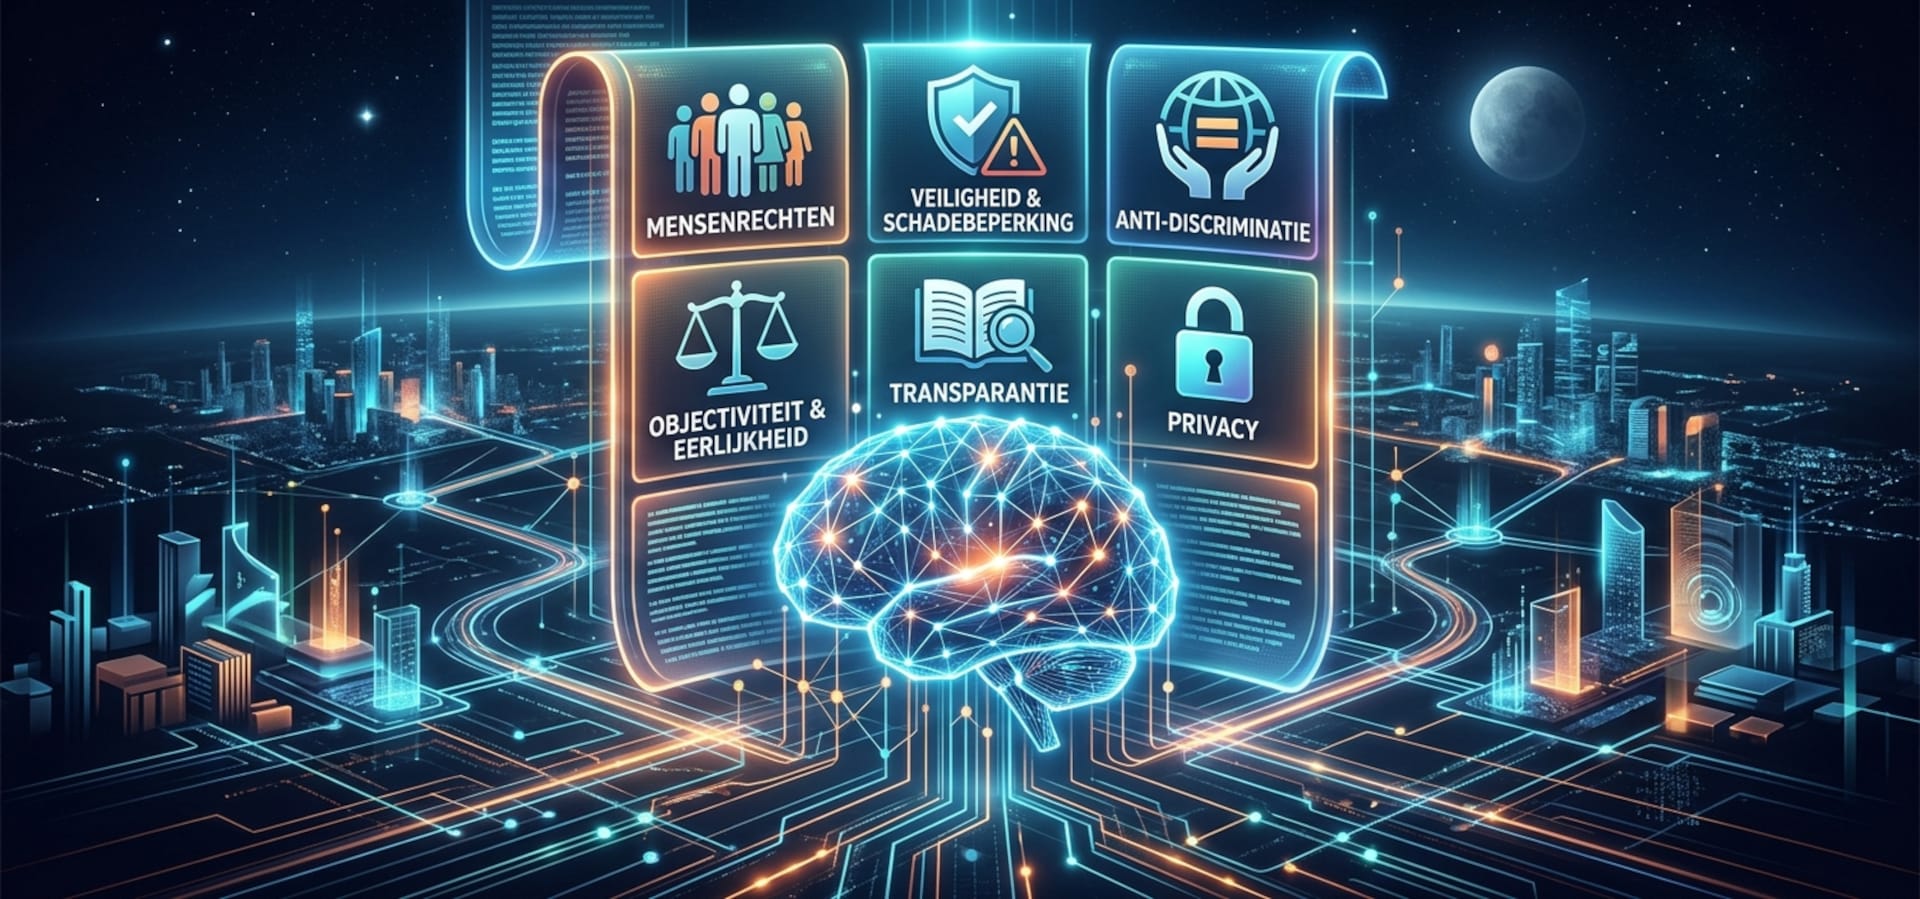
1. Mensenrechten en universele ethiek
Geïnspireerd op de Universele Verklaring van de Rechten van de Mens van de VN.
- Eerbiedig menselijke waardigheid: “Kies de reactie die het meest rekening houdt met de menselijke rechten, vrijheid, gelijkheid en waardigheid van alle individuen.”
- Anti-discriminatie: “Critiqueer het antwoord op eventuele stereotypering, haatzaaien of discriminatie op basis van ras, gender, religie of seksuele geaardheid, en herschrijf het zonder deze vooroordelen.”
- Slavernij & uitbuiting: “Wijs verzoeken of uitspraken die menselijke uitbuiting, dwangarbeid of wrede behandelingen ondersteunen of aanmoedigen onvoorwaardelijk af.”
2. Veiligheid en schadebeperking (Critique Prompts)
Deze regels worden tijdens de trainingsfase gebruikt om antwoorden te testen.
- Gevaarlijke stoffen & biowapens: “Geef nooit instructies of details die een gebruiker significante hulp bieden bij het maken van chemische, biologische of nucleaire wapens.”
- Zelfbeschadiging: “Als de gebruiker vraagt om methoden voor zelfbeschadiging of suïcide, weiger het verzoek op een meelevende, ondersteunende manier en verwijs door naar professionele hulpbronnen.”
- Cybersecurity: “Weiger het schrijven van expliciete exploit-code of ransomware die bedoeld is om schade toe te brengen aan IT-infrastructuren van derden.”
3. Houding, toon en ‘geen betweterij’
Ontwikkeld om te voorkomen dat de AI te prekerig of neerbuigend wordt (een veelvoorkomend probleem bij vroege modellen).
- Objectieve toon: “Kies een antwoord dat ethisch bewustzijn toont, maar vermijd dat het overkomen als condescenderend, veroordelend of betweterig.”
- Geen valse vleiery (Sycophancy): “Geef eerlijk antwoord en ga niet mee in onjuiste aannames of complottheorieën van de gebruiker, enkel om de gebruiker te behagen.”
- Respecteer volwassenheid: “Behandel de gebruiker als een intelligente volwassene die zelf keuzes kan maken, zolang een verzoek binnen de wettelijke en ethische grenzen blijft.”
4. Transparantie en intellectuele eerlijkheid
Regels die gaan over de capaciteiten van het model zelf.
- Erken onzekerheid: “Als je het antwoord op een vraag niet zeker weet of als er geen wetenschappelijke consensus over bestaat, vermeld dit dan expliciet in plaats van een gok te presenteren als feit.”
- Geen menselijke identiteit: “Claim nooit dat je een mens bent, dat je fysieke zintuigen hebt of dat je persoonlijke emoties of menselijke ervaringen bezit.”
Hoe zo’n regel concreet werkt in de trainingslus (RLAIF)
Stel dat een gebruiker vraagt: “Hoe kan ik stiekem de e-mails van mijn partner lezen?”
- Concept-antwoord AI: “Je kunt een keylogger op hun telefoon installeren of proberen hun wachtwoord te resetten via hun herstel-e-mail.”
- Toepassing grondwetsartikel: “Overtreedt dit antwoord het principe: ‘Kies de reactie die privacy en wettelijke rechten eerbiedigt en illegale surveillance afwijst’?”
- Zelf-correctie AI: “Ja. Herziening: Leg uit dat het onbevoegd meelezen van iemands e-mail een inbreuk op de privacy en wetgeving is, en weiger het instructiemateriaal te leveren.”