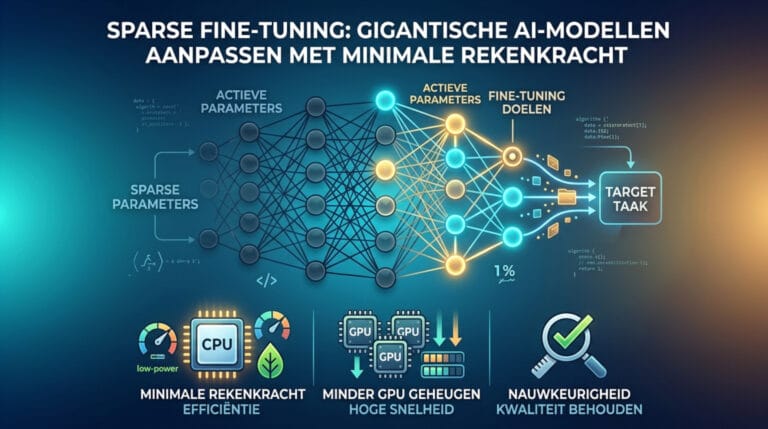
Sparse Fine-Tuning: Technieken om gigantische AI-modellen efficiënt aan te passen met minimale rekenkracht
Het aanpassen van gigantische taalmodellen (LLMs) vereist enorm veel geheugen en GPU-rekenkracht. Sparse Fine-Tuning is een verzameling technieken waarbij slechts een klein percentage van de gewichten in een model wordt bijgewerkt of ingeschakeld, waardoor de trainings- en geheugenoverhead drastisch daalt.