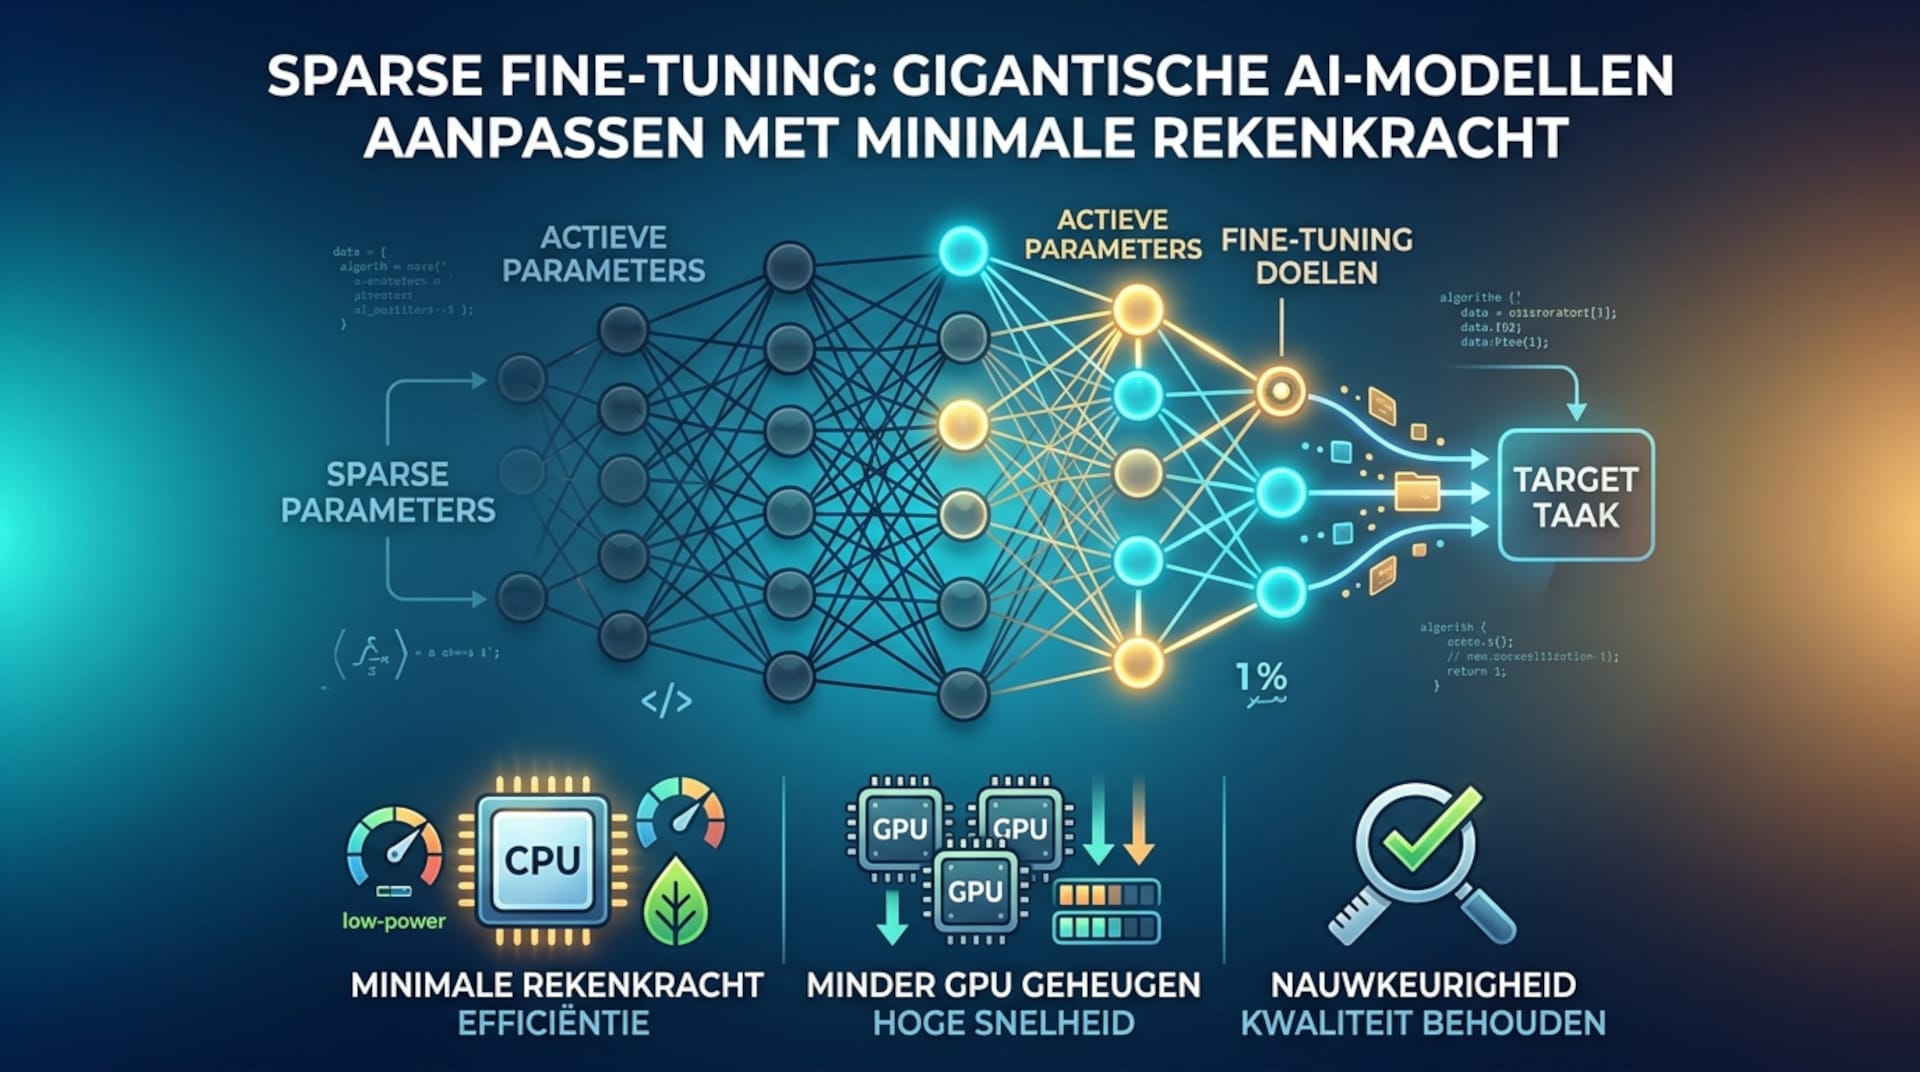

Het aanpassen van gigantische taalmodellen (LLMs) vereist enorm veel geheugen en GPU-rekenkracht. Sparse Fine-Tuning is een verzameling technieken waarbij slechts een klein percentage van de gewichten in een model wordt bijgewerkt of ingeschakeld, waardoor de trainings- en geheugenoverhead drastisch daalt.
Sparse Fine-Tuning: gigantische AI-modellen aanpassen met minimale rekenkracht
Grote AI-modellen zoals LLaMA, Mistral of GPT-varianten presteren indrukwekkend, maar het volledig her-trainen of fine-tunen van miljarden parameters kost al snel duizenden euro’s aan GPU-capaciteit. Om AI-ontwikkeling toegankelijker en efficiënter te maken, wint een slimme techniek terrein: Sparse Fine-Tuning.
In plaats van elk gewicht in een netwerk aan te passen, richt deze methode zich uitsluitend op de parameters die écht impact hebben op de nieuwe taak.
Wat is Sparse Fine-Tuning?
Bij traditionele (dense) fine-tuning worden alle parameters van een neuraal netwerk gelijktijdig bijgewerkt. Dat vereist enorme hoeveelheden VRAM om de gradiënten en optimizer-states op te slaan.
Sparse Fine-Tuning injecteert schaarsheid (sparsity) in dit proces. Het idee is simpel: 90% tot 99% van het netwerk blijft bevroren of wordt overgeslagen, terwijl slechts 1% tot 10% van de gewichten wordt getraind.
OpenReview
Het resultaat? Een drastische vermindering van het geheugengebruik en snellere iteratiecycli, zonder significant verlies aan modelnauwkeurigheid.
De belangrijkste technieken
Sparse Fine-Tuning leunt op diverse strategieën om te bepalen welke gewichten aangepast moeten worden:
1. Structurele Pruning & Dynamic Sparsity (SEFT)
Bij methoden zoals Sparsity Evolution Fine-Tuning (SEFT) start men met een reeds gesnoeid (gepruned) model. Tijdens het trainen worden presterende verbindingen ‘geactiveerd’ en onbelangrijke verbindingen uitgeschakeld. Het netwerk leert zo dynamisch welke routes binnen de architectuur het beste passen bij de nieuwe taak.
OpenReview
2. Parameter Masking & Selectie (e.g., FishMask)
Hierbij berekent de gebruiker vooraf (of tijdens de eerste stappen) de Fisher Information matrix. Deze matrix bepaalt welke parameters de meeste invloed hebben op de output. Er wordt een binair masker aangemaakt: alleen de top k% belangrijkste gewichten krijgen updates, de rest blijft ongewijzigd.
3. Hybride benaderingen: Sparse LoRA
Low-Rank Adaptation (LoRA) voegt kleine, trainbare matrixblokken toe aan het model. Door schaarsheid toe te passen op deze adapters zelf (Sparse LoRA), worden alleen de meest actieve elementen binnen de adapter-lagen geüpdatet. Dit levert nog lagere latency en een kleiner geheugenbeslag op.
Waarom Sparse Fine-Tuning de toekomst is
| Voordeel | Wat het betekent in de praktijk |
|---|---|
| Lage Hardware-eisen | Modellen van 70B+ parameters fine-tunen op consumenten-hardware of enkele GPU’s. |
| Snellere Inference | Aangezien de uiteindelijke gewichten grotendeels nul (sparse) zijn, kan het afspelen sneller worden uitgevoerd op gespecialiseerde hardware. |
| Minder ‘Catastrophic Forgetting’ | Doordat de kern van het basismodel grotendeels intact blijft, verliest het netwerk minder algemene kennis. |
Sparse Fine-Tuning helpt de barrière tussen complexe AI en beperkte rekenkracht te doorbreken. Door te focussen op de specifieke gewichten die er daadwerkelijk toe doen, kunnen ontwikkelaars en bedrijven state-of-the-art modellen op maat maken voor een fractie van de traditionele kosten.
Sparse Fine-Tuning, LoRA en QLoRA zijn alle drie Parameter-Efficient Fine-Tuning (PEFT) technieken, maar ze pakken de efficiëntieslag vanuit een andere hoek aan:
- Sparse Fine-Tuning traint alleen de belangrijkste gewichten uit het originele model en zet de rest uit.
- LoRA bevriest het originele model en voegt kleine, trainbare adapter-matrices toe.
- QLoRA quantiseert het bevroren basismodel eerst naar 4-bit precisie voordat er LoRA-adapters aan worden toegevoegd.
| Categorie | Sparse Fine-Tuning | LoRA (Low-Rank Adaptation) | QLoRA (Quantized LoRA) |
| VRAM-geheugengebruik | Gemiddeld (vereist nog steeds 16-bit basisgewichten in VRAM, maar bespaart op optimizer-states) | Laag (basismodel in 16-bit, traint <1% aan extra parameters) | Extreem laag (basismodel gecomprimeerd naar 4-bit NF4) |
| Trainingssnelheid | Snel tot gemiddeld (afhankelijk van hardware-ondersteuning voor sparse berekeningen) | Snel (lage rekenload door kleine adapters) | Iets trager (extra overhead door het continu de-quantiseren van 4-bit naar 16-bit) |
| Inference snelheid | Snel (kan op gespecialiseerde hardware erg snel zijn door minder actieve gewichten) | Zeer Snel (adapters kunnen vooraf naadloos worden samengevoegd met het basismodel) | Gemiddeld (vereist 4-bit kwantisatie bij opslag, of samenvoegen vereist her-kwantisatie) |
| Nauwkeurigheid / behoud kwaliteit | Zeer hoog (past direct relevante gewichten van het originele netwerk aan) | Hoog (benadert volle fine-tuning op bijna alle benchmarks) | Hoog (vrijwel identiek aan LoRA, minimaal verlies door 4-bit quantisatie) |
| Beste Use-Case | Specifieke taken op gespecialiseerde hardware (zoals Nvidia Ampere/Hopper met sparse tensor cores) | Algemene fine-tuning van LLM’s op standaard GPU’s | Fine-tunen van gigantische modellen (bijv. 70B+) op één enkele consumenten-GPU |